Los modelos de lenguaje de gran escala no acceden a información en tiempo real ni verifican fuentes externas por sí mismos. Funcionan prediciendo la siguiente palabra probable según patrones aprendidos durante el entrenamiento. Ese diseño explica su potencia, pero también su mayor límite: cuando carecen de datos específicos o actualizados, pueden generar respuestas plausibles pero incorrectas.
Ese problema no es un error accidental. Es una consecuencia directa de su arquitectura.
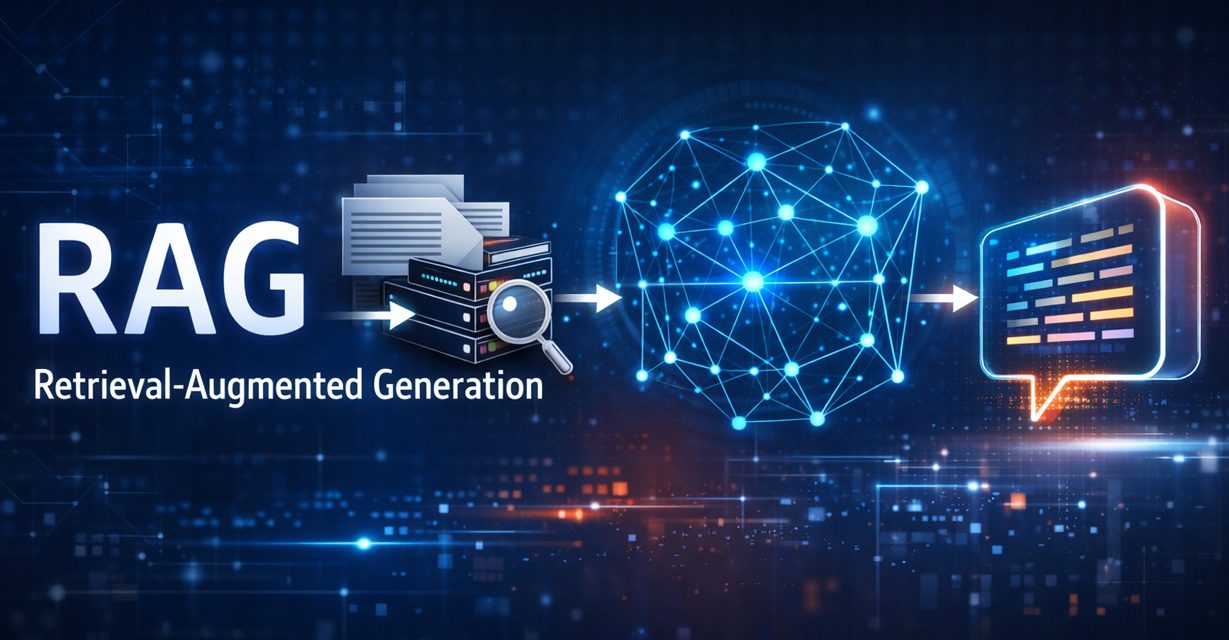
Para mitigar esa limitación surgió Retrieval-Augmented Generation, RAG. No es un modelo nuevo. Es una arquitectura que combina recuperación de información con generación de texto.
El límite del modelo cerrado
Sistemas desarrollados por organizaciones como OpenAI o Anthropic son entrenados con grandes volúmenes de datos. Sin embargo, una vez finaliza el entrenamiento, su conocimiento queda estático. No pueden consultar bases privadas, documentos internos ni información publicada después de su fecha de corte, salvo que se integren con mecanismos externos.
Cuando se les pide información precisa sobre normativas locales, reportes financieros específicos o bases documentales cerradas, el modelo puede completar vacíos mediante inferencias estadísticas. Ese fenómeno es conocido como alucinación.
El problema no es de intención ni de diseño defectuoso. Es de aislamiento informativo.
Qué hace diferente a RAG
RAG introduce una capa intermedia entre la pregunta del usuario y la generación final. El proceso ocurre en dos etapas:
- El sistema busca documentos relevantes en una base de conocimiento previamente indexada.
- Los fragmentos recuperados se incorporan como contexto explícito dentro del prompt que recibe el modelo.
El modelo no responde únicamente desde lo aprendido durante el entrenamiento, sino desde evidencia concreta suministrada en tiempo real.
Esto cambia la naturaleza de la respuesta. Ya no es solo generación estadística, sino generación condicionada por información recuperada.
Componentes técnicos esenciales
Un sistema RAG correctamente implementado incluye:
- Fragmentación estructurada de documentos en unidades manejables.
- Conversión de cada fragmento en embeddings, representaciones numéricas que capturan significado semántico.
- Almacenamiento en una base vectorial que permite búsqueda por similitud matemática.
- Recuperación de los fragmentos más relevantes mediante comparación de vectores.
- Integración de esos fragmentos en el contexto del modelo antes de generar la respuesta.
La búsqueda deja de depender de coincidencias exactas de palabras y pasa a operar sobre proximidad semántica en espacios vectoriales.
La precisión del sistema depende directamente de la calidad del corpus, la correcta segmentación, la elección del modelo de embeddings y el diseño del prompt.
RAG no es fine-tuning
El fine-tuning modifica los pesos internos del modelo para especializarlo en una tarea. RAG no altera el modelo base. Agrega una capa externa de recuperación.
Esa diferencia tiene implicaciones estratégicas:
- Permite actualizar información sin reentrenamientos costosos.
- Facilita control sobre las fuentes utilizadas.
- Reduce riesgos legales al trabajar con corpus curado.
- Separa conocimiento general de conocimiento específico.
Para organizaciones que gestionan información sensible o institucional, esa separación es clave.
Un requisito técnico, no una moda
RAG no elimina totalmente el error. Si la base documental es incompleta o está mal estructurada, la calidad de las respuestas también lo será. Sin embargo, cuando se implementa con rigor, transforma un modelo generativo generalista en un sistema especializado con trazabilidad y mayor confiabilidad.
En contextos donde la precisión informativa es estratégica, RAG no es una mejora opcional. Es una arquitectura necesaria para que la inteligencia artificial sea útil sin sacrificar control ni verificabilidad.
Experto en diseño, desarrollo, implementación proyectos multimedia (Producción de contenidos digitales visuales, sonoros y comunicativos para múltiples plataformas)